인공지능 사관학교 - 1주차 기초 파이썬 (4일차, +3일차 시간복잡도 복습)
3일차 복습 문제
문제 1: 빅오 표기법
다음 코드들의 시간 복잡도를 빅오 표기법으로 나타내시오.
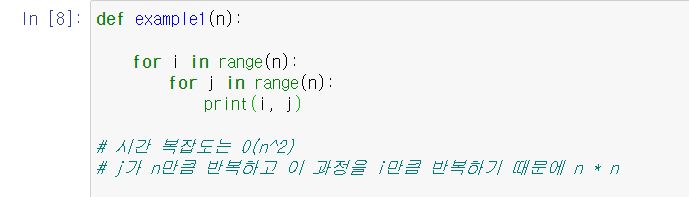
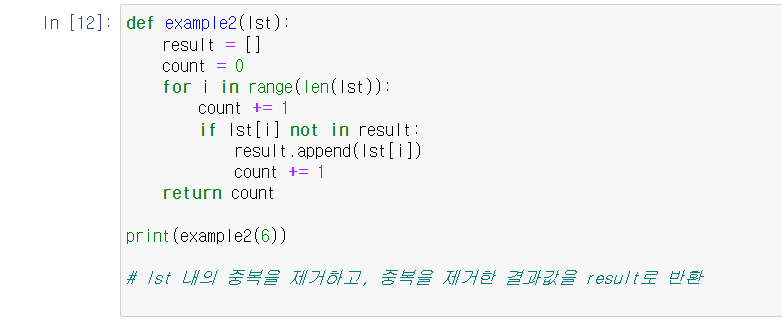
2번 문제의 경우 특성 숫자(6)를 넣고 했는데 카운트는 for문 반복횟수 6 + i가 0일때부터 result랑 비교되는 횟수 해서
6 + 1 + 2 + 3 + 4 + 5 + 6 으로 생각해서 27로 생각해서 6^2는 36이 아니니까 O(n^2)라고 생각하지 않았는데
chat GPT한테 물어보니
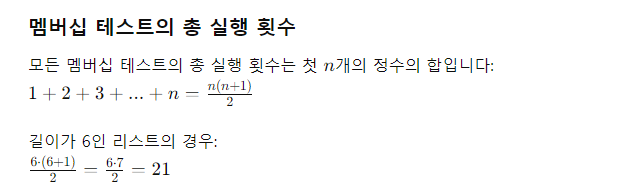
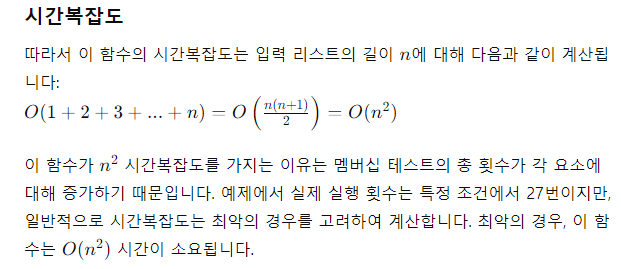
라고 한다.. 그래서 직접 파이썬 matplot 라이브러리로 나타내봤는데
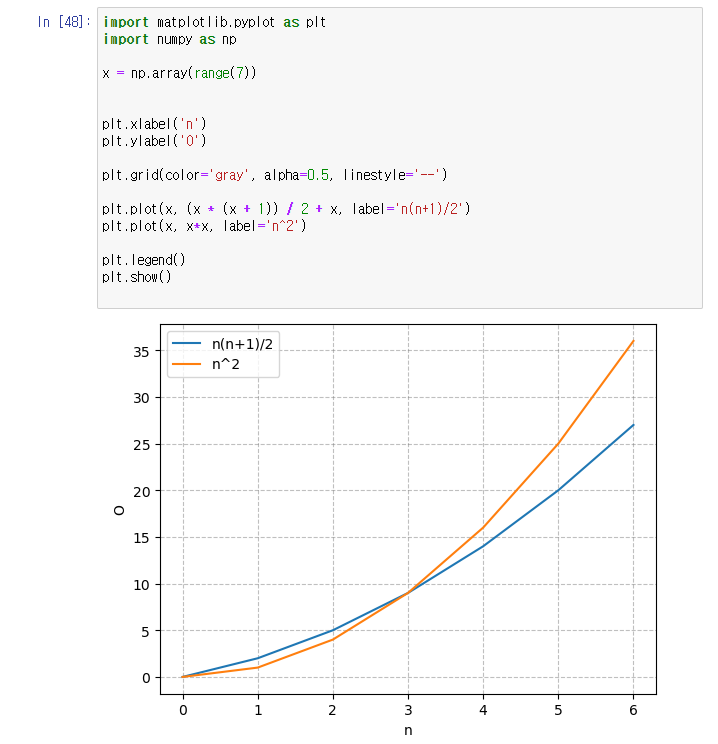
결과값은 이렇다.. 시간복잡도는 뭔가 어려운 것 같다. 이건 특정케이스라고 생각하지만,
무작정 이해하기는 쉽지 않은 것 같습니다.
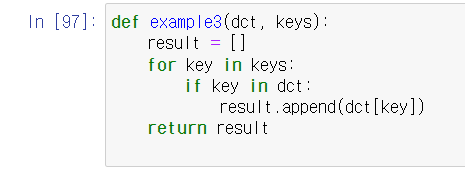
위 코드는 주어진 키 목록 keys에 대해 딕셔너리 dct에서 값을 검색하여 result 리스트에 추가하는 기능을 구현하고 있습니다. key in dct의 시간 복잡도는 O(1)입니다.
따라서 전체 코드의 시간 복잡도는 O(k), 여기서 k는 keys 리스트의 길이입니다.

위 코드는 리스트 lst에서 각 항목의 등장 횟수를 세는 기능을 구현하고 있습니다.
딕셔너리 count의 항목 접근 시간 복잡도는 O(1)이므로, 전체 코드의 시간 복잡도는 O(n)입니다.
문자열
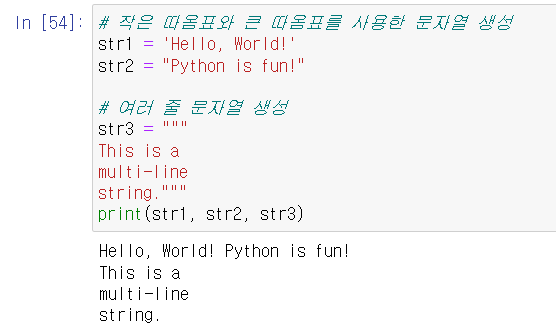
파이썬에서 문자열(String)은 문자들의 연속적인 시퀀스로, 텍스트 데이터를 다루는 데 사용됩니다. 문자열은 작은 따옴표(')나 큰 따옴표(")로 감싸서 생성할 수 있습니다.
문자열의 주요 특징
- 불변성 (Immutable): 문자열은 생성된 이후에 변경할 수 없습니다. 새로운 문자열을 생성하여 변경된 내용을 반영할 수 있습니다.
- 시퀀스 타입 (Sequence Type): 문자열은 문자들의 순서가 있는 시퀀스입니다. 따라서 인덱싱, 슬라이싱, 반복과 같은 시퀀스 연산이 가능합니다.
- 다양한 표현 방식: 작은 따옴표, 큰 따옴표, 삼중 따옴표(''' 또는 """)로 문자열을 표현할 수 있습니다. 삼중 따옴표는 여러 줄에 걸친 문자열을 생성할 때 유용합니다.
문자열 생성
문자열의 기본 연산
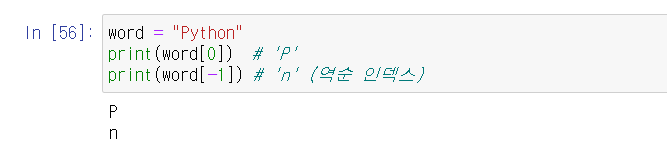
- 인덱싱 (Indexing): 특정 위치의 문자에 접근합니다. (0부터 시작)
2. 슬라이싱 (Slicing): 문자열의 부분 문자열을 추출합니다.
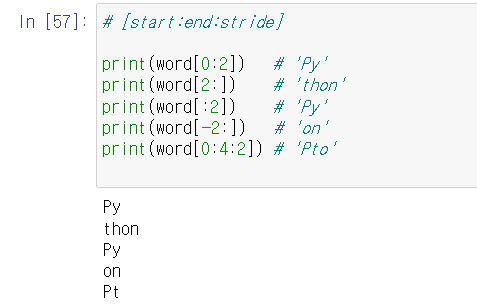
문자열의 기본 연산
- 길이 확인 (Length): 문자열의 길이를 확인합니다.
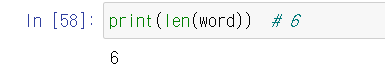
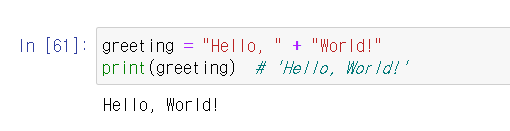
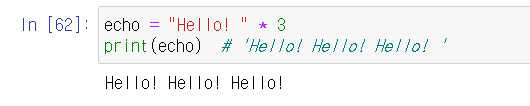
문자열의 주요 메소드
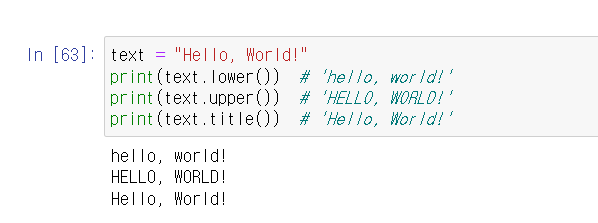
- 대소문자 변환 (Changing Case): .lower(), .upper(), .title()
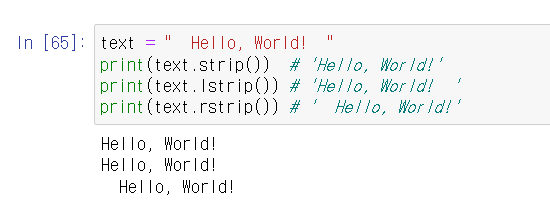
2. 공백 제거 (Trimming Whitespaces): .strip(), .lstrip(), .rstrip()
3. 문자열 분할 (Splitting Strings): split(" ")


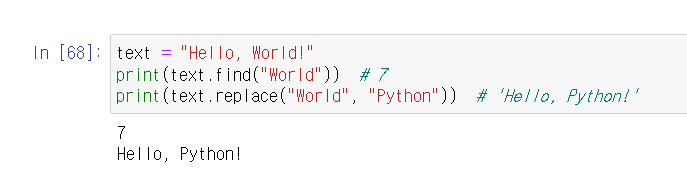
5. 문자열 검색 및 대체 (Searching and Replacing Strings):
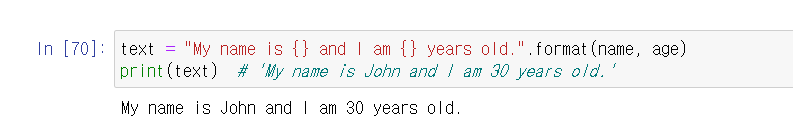
문자열 포맷팅 (String Formatting)
파이썬에서는 문자열 내에 변수를 삽입하는 다양한 포맷팅 방법을 제공합니다.
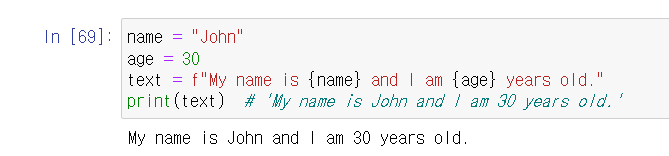
- f-strings (파이썬 3.6+):
2. str.format() 메소드:
(참고) 시퀀스
시퀀스(Sequence)는 항목들이 특정한 순서로 나열된 데이터 구조를 말합니다. 시퀀스는 항목의 순서가 중요하며, 여러 종류의 데이터 타입이 포함될 수 있습니다. 주요 시퀀스 타입으로는 리스트(List), 튜플(Tuple), 문자열(String), 레인지(Range), 바이트열(Bytes), 바이트배열(Bytearray)이 있습니다.
주요 시퀀스 타입
- 리스트 (List):
- 가변적이며 항목을 추가, 제거, 수정할 수 있습니다.
- 대괄호([])로 생성합니다.
- 예시: my_list = [1, 2, 3, 4, 5]
- 튜플 (Tuple):
- 불변적이며 생성 후 항목을 변경할 수 없습니다.
- 소괄호(())로 생성합니다.
- 예시: my_tuple = (1, 2, 3, 4, 5)
- 문자열 (String):
- 불변적이며 문자들의 시퀀스입니다.
- 작은 따옴표('), 큰 따옴표("), 삼중 따옴표(''' 또는 """)로 생성합니다.
- 예시: my_string = "hello"
- 레인지 (Range):
- 특정한 범위 내의 숫자 시퀀스를 생성합니다.
- range() 함수를 사용합니다.
- 예시: my_range = range(1, 10)
- 바이트열 (Bytes):
- 불변적이며 바이트 시퀀스를 나타냅니다.
- b'' 또는 bytes()로 생성합니다.
- 예시: my_bytes = b'hello'
- 바이트배열 (Bytearray):
- 가변적이며 바이트 시퀀스를 나타냅니다.
- bytearray()로 생성합니다.
- 예시: my_bytearray = bytearray(b'hello')
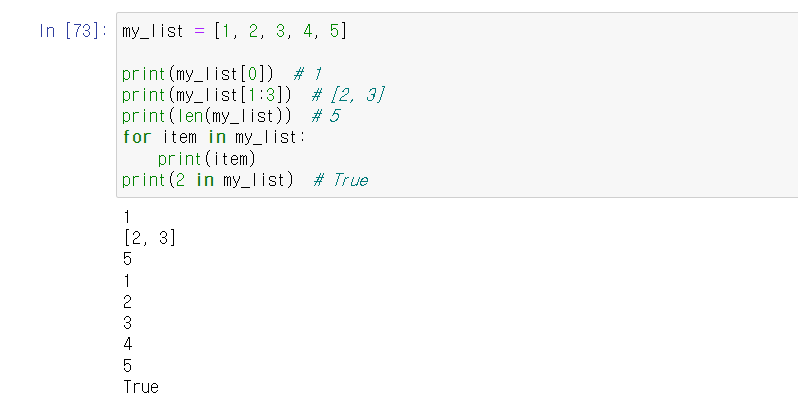
시퀀스의 공통 연산
- 인덱싱 (Indexing): 특정 위치의 항목에 접근합니다.
- 슬라이싱 (Slicing): 시퀀스의 부분 시퀀스를 추출합니다.
- 길이 확인 (Length): 시퀀스의 길이를 확인합니다.
- 반복 (Iteration): 시퀀스를 반복합니다.
- 멤버십 테스트 (Membership Test): 특정 항목의 존재 여부를 확인합니다.
시퀀스를 매개변수로 받는 함수와 객체들
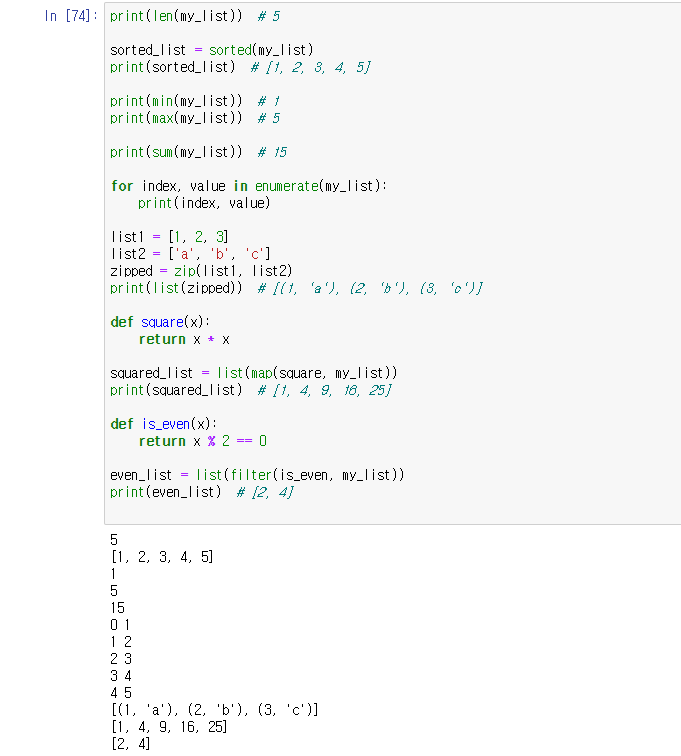
- len(): 시퀀스의 길이를 반환합니다.
- sorted(): 시퀀스를 정렬된 리스트로 반환합니다.
- min()/max(): 시퀀스의 최소값과 최대값을 반환합니다.
- sum(): 숫자 시퀀스의 합을 반환합니다.
- enumerate(): 시퀀스를 열거형 객체로 반환합니다.
- zip(): 여러 시퀀스를 병렬로 결합합니다.
- map(): 시퀀스의 각 항목에 함수를 적용합니다.
- filter(): 조건을 만족하는 항목들로 시퀀스를 필터링합니다.
시퀀스를 활용한 예제
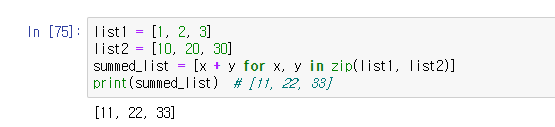
다양한 시퀀스 타입과 시퀀스를 매개변수로 받는 함수들을 결합하여 데이터를 효율적으로 처리할 수 있습니다. 예를 들어, 리스트 컴프리헨션과 zip() 함수를 사용하여 두 리스트의 항목을 결합할 수 있습니다.
스택 (Stack)
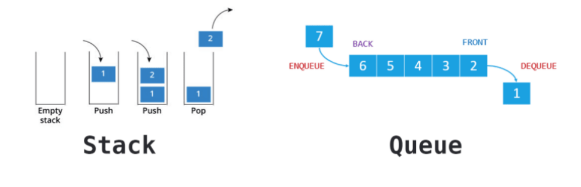
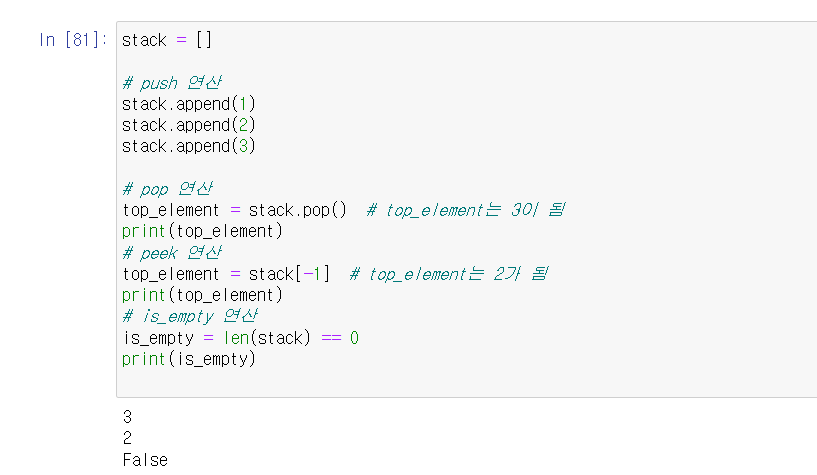
스택은 후입선출(Last In, First Out, LIFO) 원칙을 따르는 자료 구조입니다. 즉, 가장 나중에 삽입된 데이터가 가장 먼저 제거됩니다. 스택은 다음과 같은 기본 연산을 가집니다:
- push: 스택의 맨 위에 데이터를 추가합니다.
- pop: 스택의 맨 위에 있는 데이터를 제거하고 반환합니다.
- peek: 스택의 맨 위에 있는 데이터를 제거하지 않고 반환합니다.
- is_empty: 스택이 비어 있는지 확인합니다.
파이썬에서는 기본적으로 리스트(list)를 사용하여 스택을 구현할 수 있습니다. 예를 들어:
큐 (Queue)
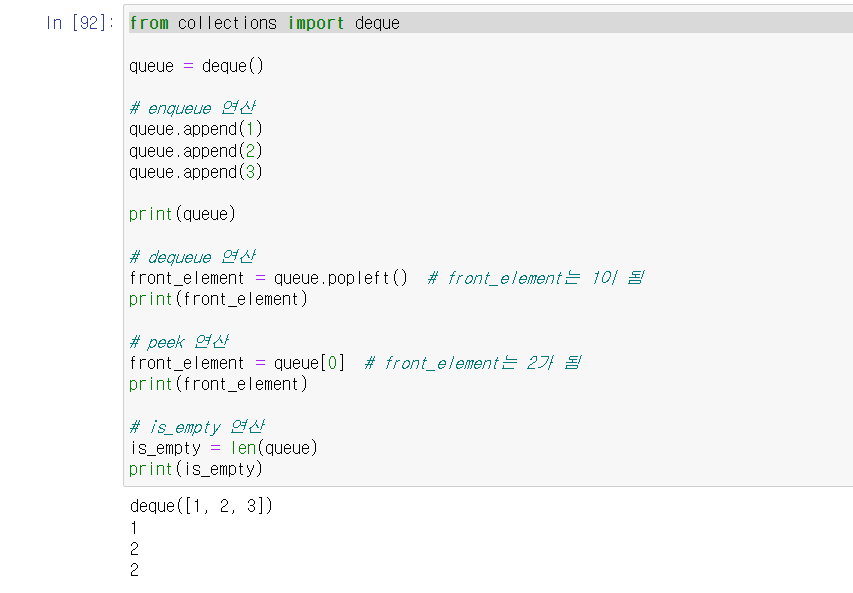
큐는 선입선출(First In, First Out, FIFO) 원칙을 따르는 자료 구조입니다. 즉, 가장 먼저 삽입된 데이터가 가장 먼저 제거됩니다. 큐는 다음과 같은 기본 연산을 가집니다:
- enqueue: 큐의 뒤에 데이터를 추가합니다.
- dequeue: 큐의 앞에 있는 데이터를 제거하고 반환합니다.
- peek: 큐의 앞에 있는 데이터를 제거하지 않고 반환합니다.
- is_empty: 큐가 비어 있는지 확인합니다.
파이썬에서는 collections 모듈의 deque 클래스를 사용하여 큐를 구현할 수 있습니다. 예를 들어:
요약
- 스택은 LIFO 원칙을 따르며, append()와 pop() 메서드를 사용하여 구현할 수 있습니다.
- 큐는 FIFO 원칙을 따르며, deque 클래스를 사용하여 append()와 popleft() 메서드를 통해 구현할 수 있습니다.
데크
주요 특징과 연산
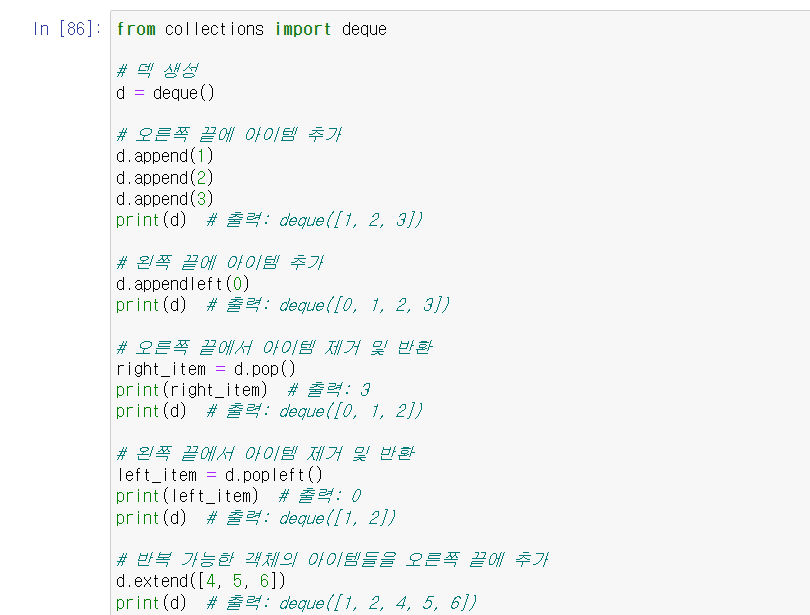
- 양쪽 끝에서의 효율적인 연산
- append(item): O(1) - 아이템을 오른쪽 끝에 추가합니다.
- appendleft(item): O(1) - 아이템을 왼쪽 끝에 추가합니다.
- pop(): O(1) - 오른쪽 끝에서 아이템을 제거하고 반환합니다.
- popleft(): O(1) - 왼쪽 끝에서 아이템을 제거하고 반환합니다.
- 기타 유용한 메서드
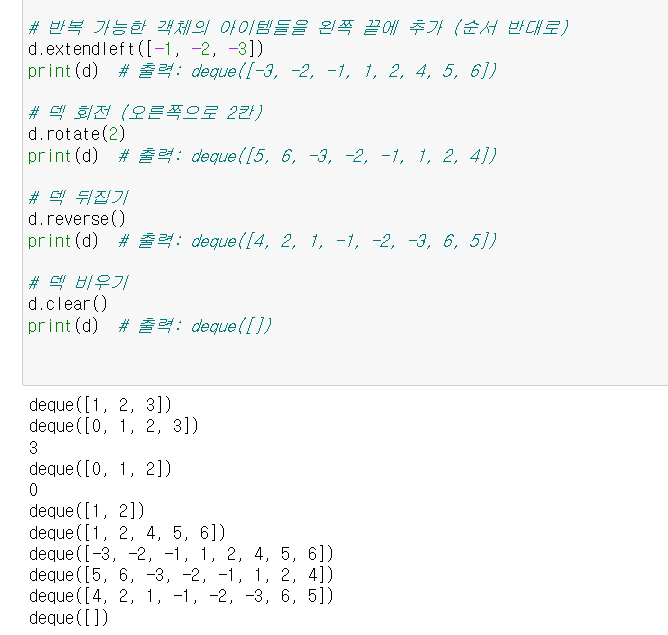
- extend(iterable): 반복 가능한 객체(iterable)의 모든 아이템을 오른쪽 끝에 추가합니다.
- extendleft(iterable): 반복 가능한 객체의 모든 아이템을 왼쪽 끝에 추가합니다. (이때 순서가 반대로 추가됩니다)
- rotate(n): 덱의 모든 아이템을 오른쪽으로 n만큼 회전합니다. n이 음수일 경우 왼쪽으로 회전합니다.
- reverse(): 덱의 아이템 순서를 뒤집습니다.
- clear(): 덱의 모든 아이템을 제거합니다.
- 특징
- deque는 양쪽 끝에서의 삽입과 삭제가 O(1) 시간 복잡도를 가지므로, 성능이 매우 뛰어납니다.
- 리스트와 달리 deque는 양쪽 끝에서의 삽입 및 삭제에 최적화되어 있어 중간에서의 삽입 및 삭제에는 적합하지 않습니다.
예제 코드
다음은 deque를 사용하는 간단한 예제입니다:
힙과 우선순위 큐
힙 (Heap)
힙은 이진 트리 기반의 자료 구조로, 다음과 같은 두 가지 종류가 있습니다:
- 최소 힙 (Min-Heap)
- 각 부모 노드가 자식 노드보다 작거나 같은 값을 갖습니다. 최솟값이 루트에 위치합니다.
- 최대 힙 (Max-Heap)
- 각 부모 노드가 자식 노드보다 크거나 같은 값을 갖습니다. 최댓값이 루트에 위치합니다.
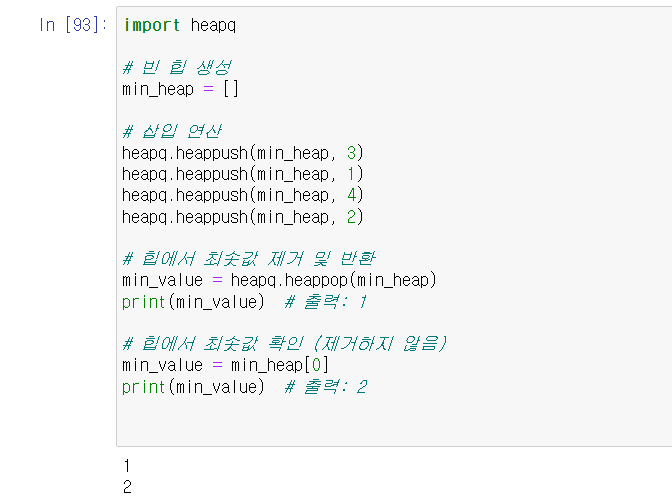
파이썬의 heapq 모듈은 기본적으로 최소 힙을 제공합니다.
주요 연산
- 삽입: 힙에 요소를 추가합니다.
- 삭제: 힙에서 최상위(최소 힙의 경우 최솟값, 최대 힙의 경우 최댓값) 요소를 제거합니다.
- 힙 정렬: 데이터를 힙 구조로 변환하여 정렬합니다.
예제 코드
다음은 heapq 모듈을 사용하여 최소 힙을 구현하는 예제입니다:
최대 힙 구현
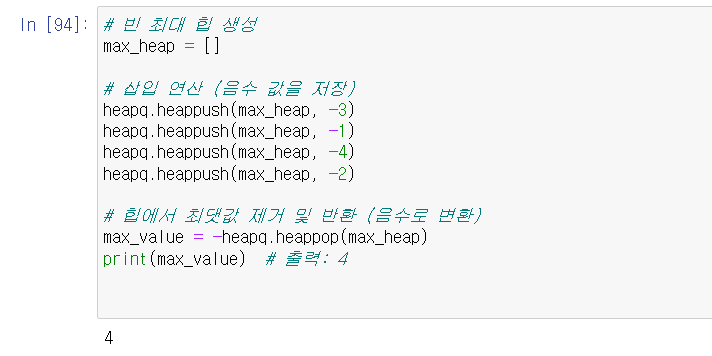
최대 힙을 구현하기 위해서는 삽입할 때 음수 값을 저장하고, 꺼낼 때 다시 음수로 변환하여 사용할 수 있습니다.
우선 순위 큐 (Priority Queue)
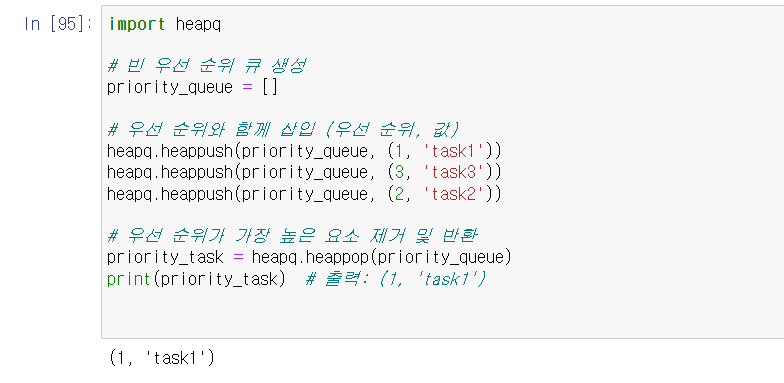
우선 순위 큐는 요소들이 우선 순위에 따라 처리되는 큐입니다. 힙을 이용하여 효율적으로 구현할 수 있습니다. heapq 모듈을 사용하여 우선 순위 큐를 구현하는 예제는 다음과 같습니다:
- 힙은 이진 트리 기반의 자료 구조로, 최소 힙과 최대 힙으로 나뉩니다. 파이썬의 heapq 모듈은 기본적으로 최소 힙을 제공합니다.
- 우선 순위 큐는 요소들이 우선 순위에 따라 처리되는 큐로, 힙을 사용하여 구현할 수 있습니다.
- heapq 모듈은 삽입, 삭제, 정렬 등의 연산을 효율적으로 수행할 수 있도록 합니다.